语言模型和人脑是否以相似方式推理?
神经科学表明,人类的语言更多是服务于交流的系统,而非复杂思维的必要条件,但该结论不能简单平移到人工智能领域。大语言模型已能完成推理、规划、工具使用等任务,这究竟是模型对训练语料统计规律的利用,还是学到了类似人脑的内部表征,有待进一步探究。尤其对于逻辑推理这类高阶认知任务,语言模型与人脑表征的关系仍缺乏系统证据。即使模型与人脑存在对齐,人脑信号能否用于引导模型进行鲁棒推理,仍是一个开放问题。
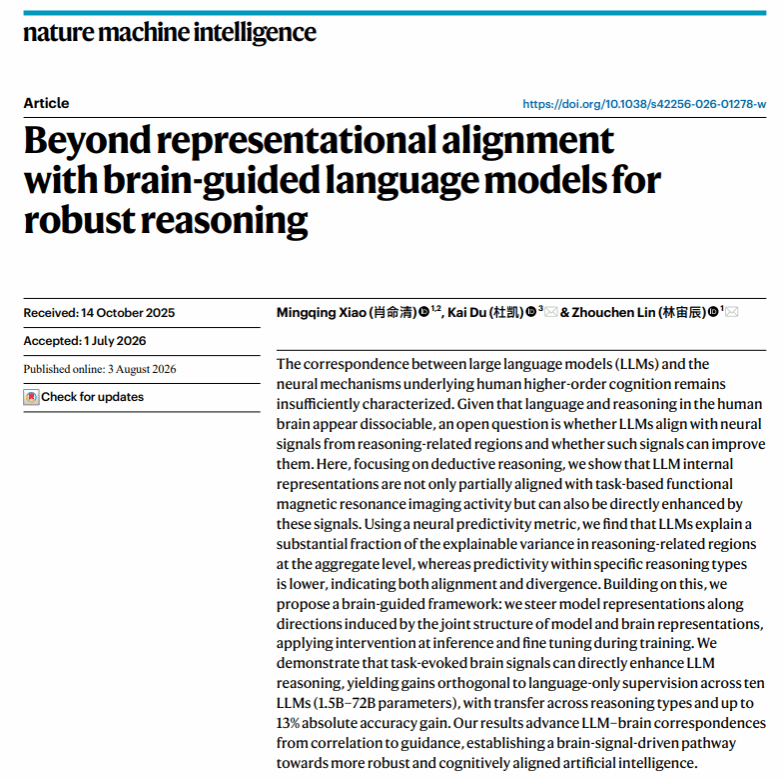
近日,实验室林宙辰课题组系统回答了这一问题。林宙辰课题组联合清华大学等单位,在 Nature Machine Intelligence 发表题为“Beyond representational alignment with brain-guided language models for robust reasoning”的研究论文。研究发现,语言模型的内部表征与人脑推理相关脑区的任务态fMRI活动存在部分对齐关系;更重要的是,可利用脑信号诱导的方向,在推断阶段干预模型表征,或在训练阶段微调模型参数,从而将模型与人脑之间的“表征对齐”转化为可提升推理鲁棒性的“神经引导”。
能否用大脑引导模型:演绎推理中的部分表征对齐
语言模型与人脑表征之间是否存在对应关系,已有神经可预测性(neural predictivity)范式提供了表征对齐的分析工具。然而,既有工作大多停留在相关性描述层面,对于这种对应是否具有功能意义,即脑信号能否反过来改善模型行为,仍缺乏系统性的证据。
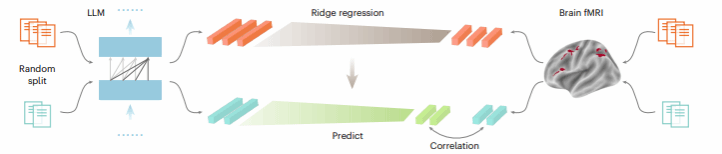
神经可预测性计算示意图
研究将上述范式扩展至演绎推理,以考察语言模型内部表征与人脑推理相关脑区的对应关系。团队使用公开的任务态fMRI数据,参与者完成三段论推理与传递关系推理两类任务;同时让Qwen、Llama、Mistral、Phi、Gemma等系列的10个开源模型处理相同刺激,参数规模覆盖1.5B至72B,并提取模型内部的激活表征。此外,团队还分别计算了模型表征与大脑演绎推理脑区、多重需求网络及核心语言网络的神经可预测性。
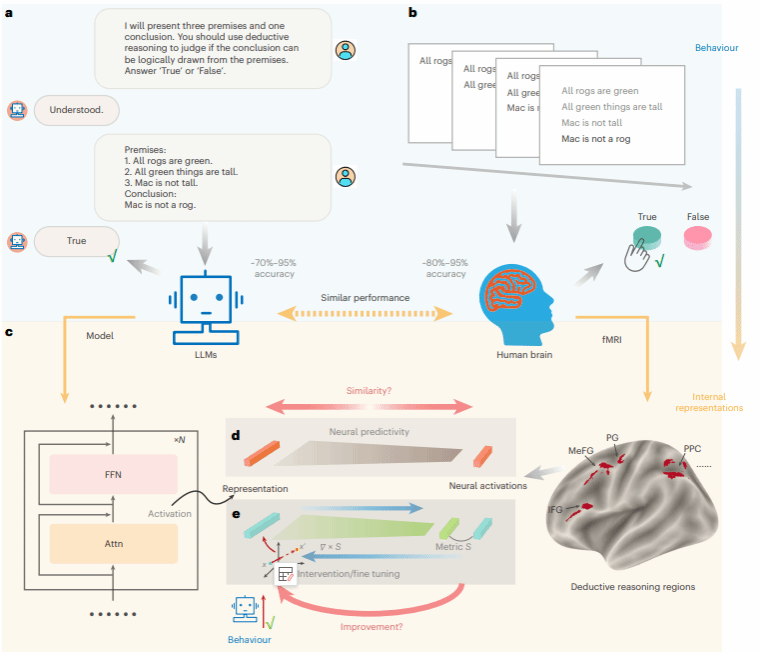
演绎推理任务示意图
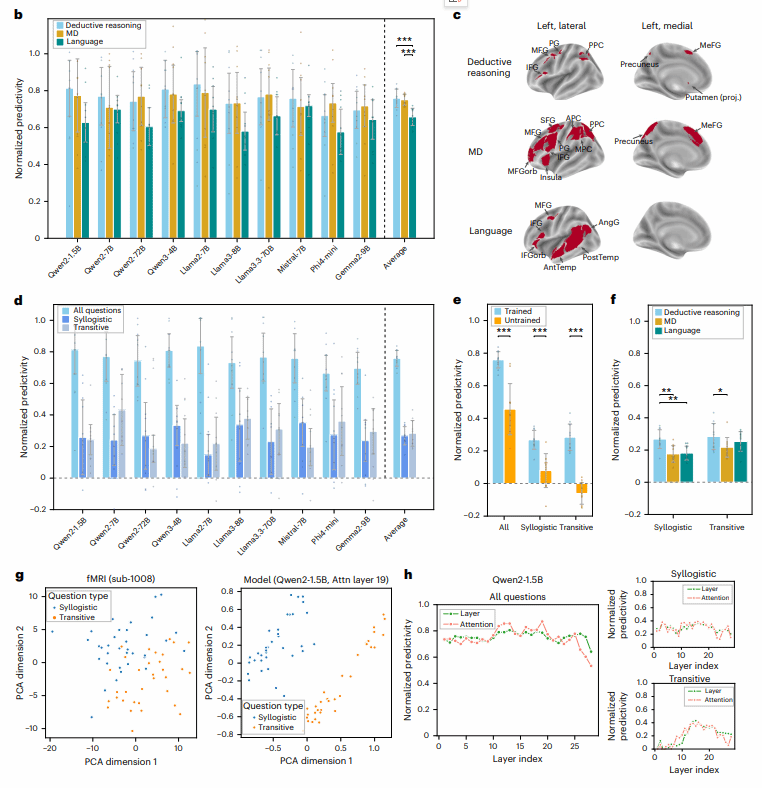
神经可预测性结果
结果显示,模型表征平均可解释推理相关脑区约76%的可解释方差,且演绎推理脑区与多重需求网络的神经可预测性显著高于核心语言网络,这种区域特异性在不同模型家族中保持一致,为“部分对齐”提供了系统的量化证据:模型确实捕捉到了与人脑推理活动部分共享的结构,但在细粒度推理类型内部,差异仍然存在。
从相关性描述到功能性引导
研究工作的重点推进在于,不再仅仅追问语言模型“是否像大脑”,而是检验人脑信号能否作为功能性的引导资源,直接改善模型的推理鲁棒性。
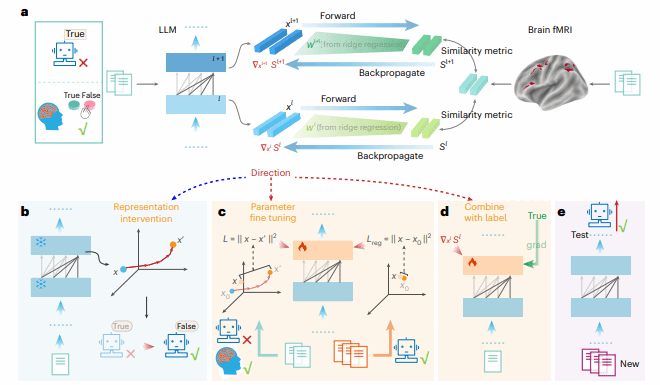
神经引导方法示意图
具体而言,该方法首先学习从模型隐藏状态到fMRI空间的线性映射;随后针对模型回答错误但人类回答正确的问题,计算映射后的模型表征与真实脑活动的相似度指标,并将该指标对模型隐藏状态求梯度,从而得到模型隐空间中的神经引导方向,该方向由模型表征与大脑表征的联合结构决定。
该方向有两种用法:神经活动引导的表征干预(NARI)在模型推断过程中直接引导修改内部表征,不更新参数;神经活动引导的表征微调(NARF)则通过微调训练,将表征方向的知识内化到模型参数中。
NARI与NARF:把脑信号变成模型可用的引导方向
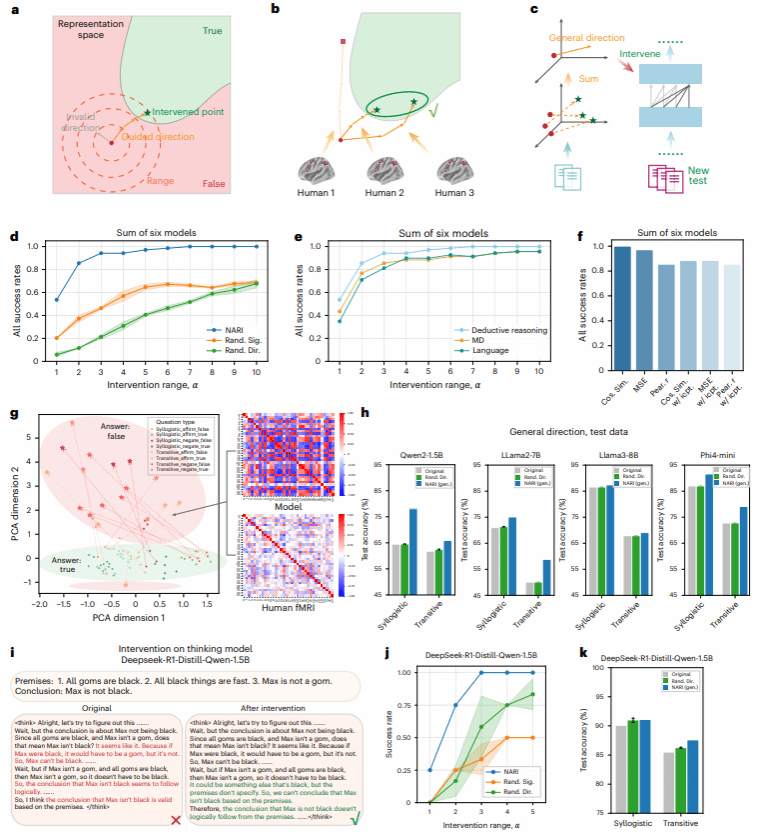
NARI针对模型原本回答错误而人类参与者回答正确的问题,在模型中间层的注意力输出上施加受约束的神经引导。在NARI设置下,对于纳入分析的原始错误问题,该方法实现了100%的纠错覆盖,显著优于随机脑信号基线和随机方向基线。进一步聚合多个问题与参与者的成功干预方向后,所得通用方向可迁移至新的推理问题,并能在一定程度上扩展至具有思维链的模型推理过程。
NARF通过参数微调使模型中间表征接近脑信号引导的目标,将表征层面的知识内化到参数中,以提升模型推理的鲁棒性。其结果同样明确:微调后的模型在不同前提数量和排列顺序下均获得稳定提升,正确与错误逻辑问题在中间层的分离也更加清晰,且增益可迁移至命题推理,说明模型学到的并非具体问题的表征,而是具有一定跨问题、跨推理类型泛化能力的表征知识。
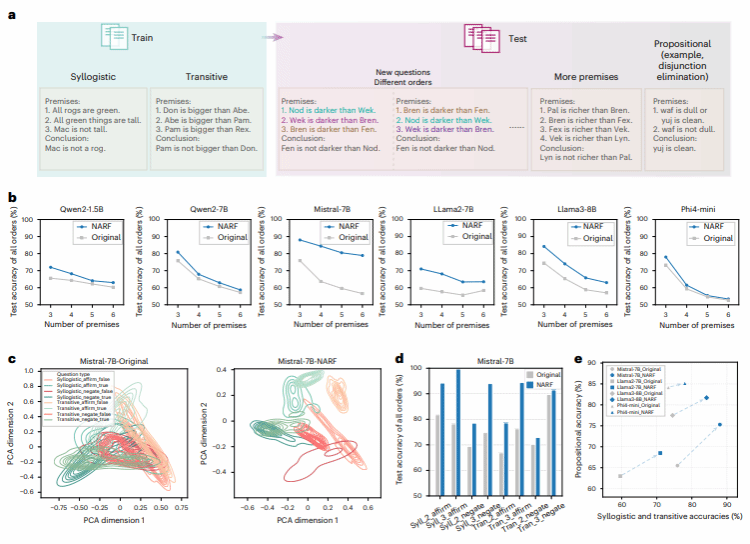
脑信号引导的参数微调结果
与语言监督互补:脑信号提供的增益不能由常规训练替代
研究还将神经引导与常规语言监督进行结合:语言监督通过最终输出词元的交叉熵损失,直接约束模型输出正确答案;NARF则同步推动中间表征向更接近人脑任务态神经活动的方向调整。实验结果显示,加入脑信号引导后,模型准确率相较仅使用语言监督的情况实现了稳定提升,平均提升约2.2个百分点;在涵盖不同逻辑结构的命题推理与自然语言一阶逻辑推理任务中,最高提升幅度可达13.2个百分点。这种互补性表明,脑信号引导作用于内部表征层面,能够提供语言层面输出约束之外的另一类信息,二者可共同参与训练,而非相互替代。研究同时测试了采用合成训练数据进行语言监督训练的设定,结果显示神经引导依然能带来额外增益。
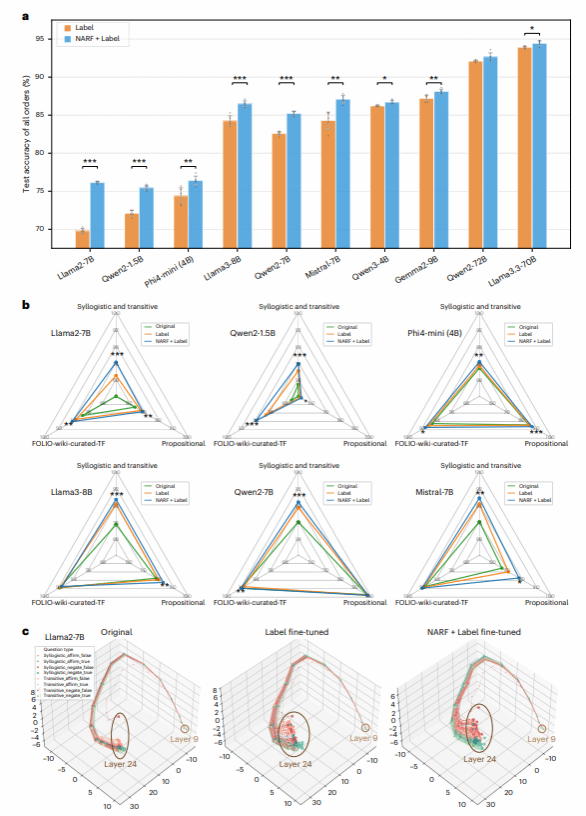
脑信号引导的参数微调与语言监督相结合的结果
这些结果均说明,神经引导可作为一种补充性的学习信号来源。研究还将该框架扩展至人类连接组计划(Human Connectome Project)的关系加工任务,结果显示任务态脑活动同样能诱导出有效的表征干预方向,且神经引导可在语言监督的基础上实现稳定增益,证明该框架并不局限于单一的演绎推理数据集。
这项研究将语言模型与人脑的关系从相关性的表征分析推进至功能性的神经引导,为脑启发人工智能开辟了一条新路径。结果表明,模型与人脑推理相关区域存在部分且具有脑区特异性的表征对应,这种部分的共享结构还可以转化为推理阶段的表征干预和训练阶段的参数监督,并为常规语言监督提供额外增益。
当然,该研究依赖于特定任务态fMRI数据的可得性与质量,脑信号引导方向的可迁移边界仍需在更广泛的认知任务与模型架构中进一步检验。不过,就演绎推理这一高阶认知能力而言,该工作已明确证明,人脑活动所携带的引导信息可以突破模型表征静态相似性的局限,成为改善人工推理系统的有效信号。未来,研究人员有望利用更高时间分辨率的EEG、MEG等模态数据,以及覆盖更复杂认知过程的神经数据,开展更细粒度的分析与引导。